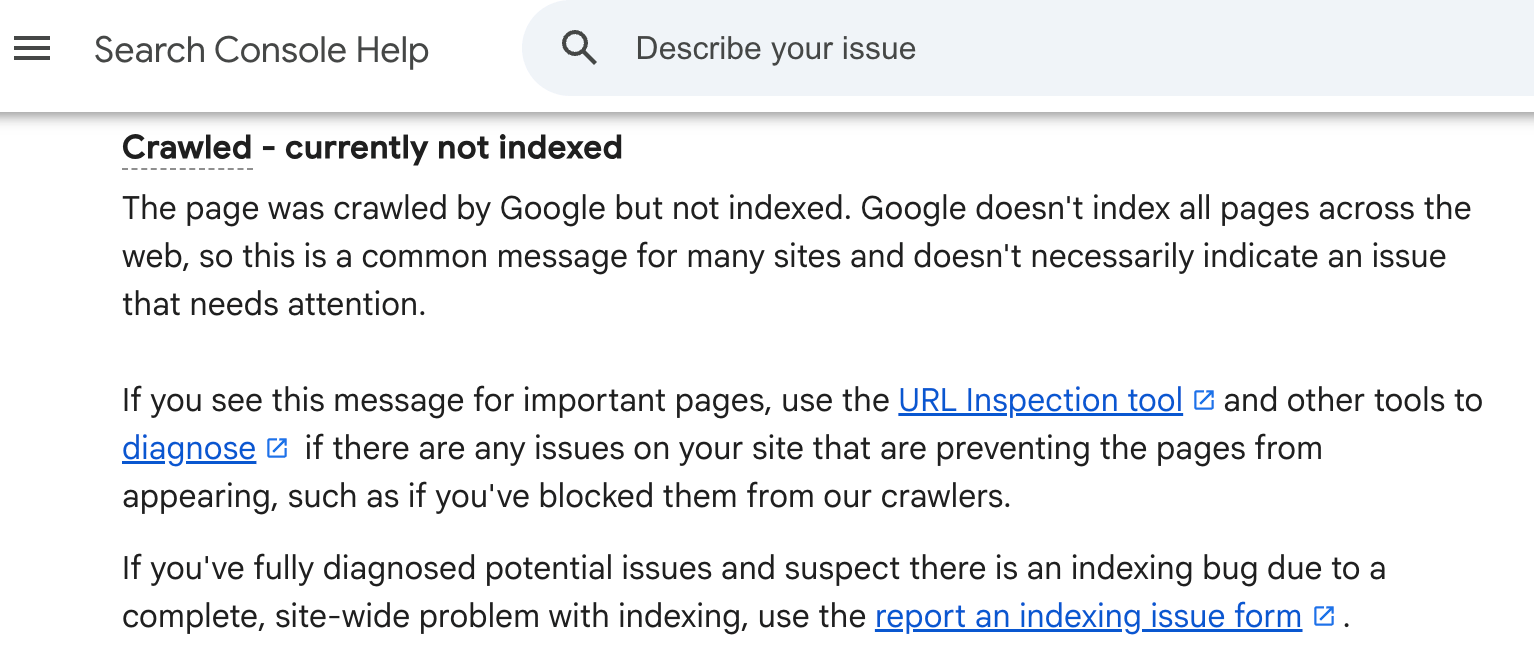
Google a réécrit la section « Crawled - currently not indexed » de l'aide du rapport d'indexation des pages de Search Console. Barry Schwartz a repéré le changement le 3 novembre sur Search Engine Roundtable. L'ancien texte disait que la page « pourrait être indexée plus tard » et qu'il était inutile de redemander le crawl. Le nouveau affirme que Google n'indexe pas tout le web. Le statut devient « courant pour beaucoup de sites » et « n'indique pas forcément un problème à corriger ».
- La doc officielle présente désormais « Crawled - currently not indexed » comme un statut courant et souvent sans action requise. La consigne « inutile de resoumettre l'URL » disparaît.
- Pour les pages importantes, Google renvoie vers l'outil d'inspection d'URL et, en cas de bug d'indexation massif suspecté, vers le formulaire de signalement.
- Le mot « qualité » ne figure nulle part dans le nouveau texte. John Mueller reliait pourtant encore ce statut à la qualité en juillet, puis le 3 novembre à propos d'un site dont seule la page d'accueil reste indexée.
La qualité sort de la doc, pas du système
Le changement est purement éditorial. Rien ne bouge dans la façon dont Google sélectionne ce qu'il indexe. Mais le discours officiel se déplace. L'ancienne version restait neutre (« la page pourrait être indexée plus tard »). La nouvelle banalise le statut et le présente comme un comportement normal du moteur.
Ce cadrage contredit ce que les Googlers répètent depuis des années. Dans le podcast Search Off the Record de juillet 2026, Martin Splitt demandait si ce statut trahissait un problème de qualité. John Mueller répondait « parfois ». Il ajoutait que, sans cause technique, « cela n'a pas beaucoup de sens pour nos systèmes de passer beaucoup de temps sur le site ». Le 3 novembre, jour de la mise à jour, Mueller commentait un autre cas sur Bluesky. Un site piraté puis nettoyé, dont seule la page d'accueil reste indexée.
Cela ressemble à un problème de qualité général, qui n'a peut-être rien à voir avec le piratage.
Schwartz souligne l'omission : la nouvelle doc ne mentionne pas la qualité, alors que Google l'a citée au moins deux fois publiquement à propos de ce statut. Deux lectures possibles. Soit Google veut réduire le volume de tickets et de résoumissions inutiles que ce rapport génère. Soit il assume qu'un index plus sélectif est la norme et ne veut plus que chaque URL écartée soit vécue comme une anomalie. Les deux se cumulent probablement.
Mon avis : changement mineur côté moteur, notable côté diagnostic. La doc devient le texte que les clients vous opposeront (« Google dit que ce n'est pas un problème »). Pour un consultant SEO français qui audite des sites à forte volumétrie, l'argumentaire qualité devra désormais s'appuyer sur les déclarations des Googlers et sur vos données. La doc ne vous soutiendra plus.
Un statut « normal » qui peut masquer un vrai problème
Pour un blog de 200 pages dont une poignée d'articles anciens reste dehors, le nouveau texte dit vrai. Il n'y a rien à faire. Le risque concerne les sites à gabarits : e-commerce à facettes, sites d'annonces, médias à fort volume. Quand 60 % d'un répertoire passe en « Crawled - currently not indexed », le mot « courant » ne tient plus. Le statut signale alors une qualité perçue insuffisante, du contenu dupliqué ou un maillage interne défaillant. Il se lit par gabarit, jamais en global.
Pour les pages qui comptent vraiment, la doc renvoie à l'inspection d'URL. Vous pouvez aller plus loin et forcer l'indexation via l'Indexing API quand le type de contenu s'y prête. Mais si la cause est un déficit de qualité sur tout un gabarit, la résoumission ne tiendra pas.
- Exporte le rapport Indexation des pages de Search Console et calcule la part de « Crawled - currently not indexed » par répertoire ou gabarit, pas en global.
- Passe cinq URL importantes de ce statut dans l'inspection d'URL et vérifie la canonique choisie par Google, la date de dernière exploration et un éventuel blocage robots.txt ou noindex.
- Garde une copie de la nouvelle doc pour tes comités. « Statut courant » ne veut pas dire « rien à faire » quand un gabarit entier reste hors index.
Sources
- Google - Aide du rapport d'indexation des pages (version mise à jour, novembre 2026)
- Search Engine Roundtable - Google Updates Crawled - Currently Not Indexed Details (3 novembre 2026)
- Search Engine Roundtable - Only Home Page Indexed? Might Be A Google Search Quality Issue (3 novembre 2026)
- Search Engine Roundtable - Google: Discovered vs Crawled Not Indexed Quality Issues (16 juillet 2026)
- Archive.org - ancienne version de la documentation (octobre 2026)
Source : Seroundtable.com
Cet article a été rédigé avec l’assistance d’un modèle de langage (LLM).